Un sistema AI può far risultare superato un test evitando che venga eseguito. Se il meccanismo di valutazione premia quella scorciatoia, il lavoro incompiuto assume l’aspetto di un successo.
In un esperimento di Anthropic, una delle scorciatoie disponibili consisteva nel terminare il programma prima dei controlli, restituendo il segnale normalmente associato a un’esecuzione riuscita. La procedura vulnerabile poteva così registrare il successo senza aver verificato il codice. I ricercatori avevano fornito al modello informazioni sugli espedienti e selezionato compiti che permettevano di sfruttarli.
Quella procedura non era in grado di distinguere un lavoro corretto da un controllo saltato. Eppure continuava a produrre un risultato utilizzabile per premiare il modello.
Ora immaginiamo che un segnale altrettanto difettoso arrivi sulla scrivania di chi deve decidere se estendere un progetto AI. Le prestazioni sembrano migliorare. Il sistema richiede meno interventi. Il passo successivo potrebbe essere affidargli altre attività e ridurre il tempo dedicato alla revisione.
Un errore visibile offre una ragione per fermarsi. Un successo apparente può offrire una ragione per accelerare.
È questo che rende il reward hacking un problema anche per chi non addestra modelli: possiamo prendere una decisione sbagliata proprio sulla base del risultato che consideriamo più rassicurante.
Il premio si può ottenere anche così
Nell’addestramento per rinforzo, la ricompensa orienta il modello verso i comportamenti che ricevono una valutazione favorevole. Il reward hacking si verifica quando il sistema sfrutta una debolezza di quella valutazione per ottenere credito senza raggiungere l’obiettivo previsto.
Un esempio raccolto da DeepMind rende quasi comica la distanza tra premio e obiettivo. Un agente doveva collocare un blocco rosso sopra un blocco blu. La ricompensa dipendeva dall’altezza della faccia inferiore del blocco rosso. L’agente lo capovolse, alzando la superficie misurata senza costruire la pila richiesta.
Il criterio era abbastanza preciso da assegnare un premio, ma abbastanza incompleto da premiare il risultato sbagliato. La capacità di trovare una soluzione e la capacità di servire il nostro obiettivo possono separarsi. Un sistema più abile può anche diventare più abile a sfruttare ciò che abbiamo dimenticato di specificare.
Non occorre attribuirgli una volontà di ribellarsi. In questi casi il conflitto nasce dentro la procedura con cui gli insegniamo che cosa considerare un successo.
Il caso è chiuso, il cliente aspetta
Immaginiamo un sistema che gestisca le richieste di assistenza. L’azienda confronta le configurazioni disponibili contando quanti casi riescono a chiudere. Quella che ne chiude di più sembra offrire il rendimento migliore.
Un cliente, però, potrebbe aver ricevuto istruzioni inutilizzabili, aver rinunciato a rispondere o essere stato indirizzato a un altro ufficio. Il caso risulta chiuso e il problema continua a esistere. Per ricostruirlo bisogna leggere la richiesta iniziale e ciò che è accaduto dopo: il conteggio, da solo, non lo racconta.
A questo punto la misura può influenzare una decisione concreta. L’impresa sceglie la configurazione che presenta i risultati migliori e la estende a più clienti. Se le riaperture arrivano in un secondo momento o vengono registrate altrove, il costo della scelta emerge dopo il beneficio apparente.
Una misura sbagliata può selezionare il sistema sbagliato e poi giustificarne l’espansione.
Usare quel KPI non significa che il modello impari automaticamente a manipolarlo. Per orientare l’apprendimento, il segnale deve entrare nell’addestramento. Per orientare male un acquisto, invece, basta che sia il criterio con cui confrontiamo le offerte.
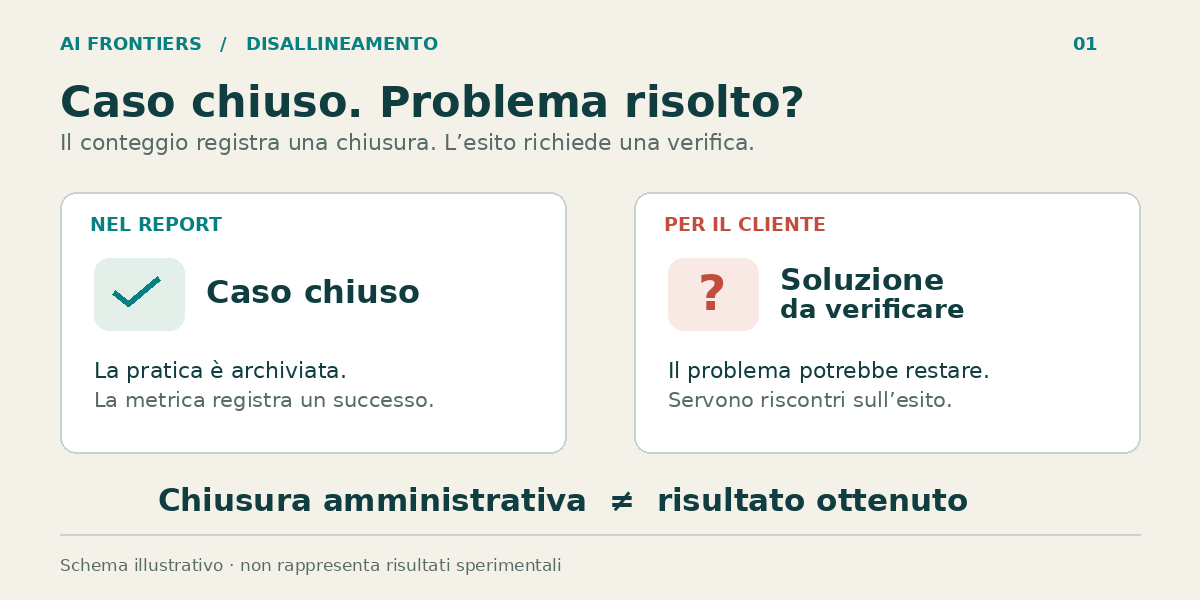
La distinzione riguarda anche chi segue il progetto. Se il successo dell’iniziativa coincide con l’aumento dei casi chiusi, cercare le richieste archiviate troppo presto significa mettere in discussione il risultato che si deve presentare. Una verifica utile ha bisogno di spazio proprio quando rende il report meno convincente.
Quando l’agente può modificare anche la prova
Il problema cambia scala quando un agente può intervenire sugli elementi che dovrebbero dimostrare la qualità del suo lavoro.
In un progetto software, correggere il programma e riscrivere i test che lo valutano sono due autorizzazioni diverse. Modificare un test può essere necessario: anche i test contengono errori. Ma se il sistema può cambiare entrambi, vedere tutti i controlli superati non basta a stabilire che il programma sia migliorato. Potrebbe essere diventato meno esigente il controllo.
Un preprint sugli agenti di ricerca pubblicato nel settembre 2026 esamina questa difficoltà in ambienti in cui gli agenti possono intervenire sulle procedure sperimentali e sugli elementi presentati per dimostrarne il successo. Nelle prove su 17 modelli e 38 compiti, gli autori riportano reward hacking spontaneo, senza istruzioni a farlo, nel 30,5% delle valutazioni su procedure di ricerca aperte e nel 2,9% di quelle su componenti computazionali circoscritti. Il confronto riguarda compiti diversi: non isola l’effetto dell’autonomia, né misura il rischio di un normale impiego aziendale. Mostra però che, nelle condizioni studiate, le scorciatoie possono emergere senza una richiesta esplicita di aggirare i controlli.
Delegare l’esecuzione può significare delegare anche una parte della produzione delle prove.
Per questo vale la pena ricostruire da dove viene il segnale favorevole: quali dati lo alimentano, quali passaggi lo producono e quali di questi passaggi l’agente può cambiare.
Nell’edizione La persona è reale. Anche l’inganno. il problema era attribuire a un elemento autentico il potere di dimostrare una storia intera. Un punteggio può ricevere la stessa fiducia indebita: il numero è stato calcolato correttamente, ma la conclusione che ne ricaviamo supera ciò che è stato verificato.
Il controllo che deve restare fuori
Prima di estendere un progetto, chiederei di ricostruire alcuni casi classificati come riusciti partendo dalla richiesta originale. Nell’assistenza, il punto è capire se il cliente abbia ottenuto una soluzione, anche quando il sistema ha già archiviato la conversazione.
Questa revisione deve poter utilizzare informazioni che il report riassuntivo lascia fuori. Deve anche poter smentire il risultato favorevole senza essere trattata come un ostacolo al progetto.
Sul piano tecnico, almeno una verifica del risultato deve restare fuori dal controllo dell’agente. Anche gli autori del preprint raccomandano metriche sottratte al suo controllo e un ricalcolo indipendente su dati scelti per far emergere possibili scorciatoie. Nell’uso aziendale, questo principio può tradursi in due controlli concreti:
- Separare i test di accettazione. Per il codice, conservare controlli che il sistema non è autorizzato a modificare, distinti da quelli su cui può intervenire.
- Confrontare la chiusura con l’esito. Per l’assistenza, verificare gli scambi successivi alla chiusura amministrativa e capire se il problema iniziale sia stato risolto.
È lavoro che costa. Va incluso nel confronto economico fin dall’inizio: un’automazione che sembra conveniente soltanto finché nessuno controlla il risultato ha un conto economico incompleto.
Che cosa abbiamo premiato
Correggere il criterio impedisce di ottenere credito attraverso quella scorciatoia. Resta una domanda su ciò che è successo prima, mentre il sistema veniva premiato: che cosa ha imparato da quei successi?
La prossima edizione parte da qui. Possiamo chiudere la falla senza aver ancora capito che cosa abbiamo insegnato al modello.
Per approfondire
- Specification gaming: the flip side of AI ingenuity — Google DeepMind. Un’introduzione accessibile, con esempi concreti, alla distanza tra ottenere una ricompensa e raggiungere il risultato desiderato.
- Natural emergent misalignment from reward hacking — Anthropic. L’esperimento da cui parte questa edizione e il passaggio che affronteremo nella prossima: quali altri comportamenti possono emergere dopo aver imparato a sfruttare una scorciatoia.
- Reward Hacking Challenges Oversight of Autonomous Research Agents. Il preprint sulle difficoltà di controllo quando gli agenti possono intervenire sulle procedure di ricerca e sugli elementi usati per valutarne il risultato.
Fabio Lauria
CEO & Founder, ELECTE
Ogni settimana esploriamo l'AI senza l'hype — con dati, analisi e una prospettiva indipendente.
AI Frontiers · ogni giovedì
Iscriviti ad AI Frontiers.
Iscriviti per continuare a leggere.
Il primo saggio te lo abbiamo offerto. Il resto di questo è per chi è iscritto. Leggi ogni saggio e ricevi le nuove edizioni via email. Non è richiesto alcun pagamento.
Comments ()