Gli editori hanno appena battuto Meta su un paragrafo di contratto, e nei loro conti non è cambiato nulla. La partita che conta è un’altra, e la stanno perdendo a tavolino.
Il 5 novembre Meta ha sospeso le nuove condizioni commerciali con cui ogni azienda titolare di un account Facebook o Instagram avrebbe accettato per iscritto di far leggere il proprio sito ai crawler di Meta. Sono bastate tre settimane. Il 16 ottobre Meta ha tolto dal testo la parola “train” (addestrare), poi ha rinviato l’entrata in vigore al 20 novembre, il 28 ottobre ha perso davanti a un tribunale di Oslo contro dieci gruppi editoriali norvegesi, il 3 novembre ha perso di nuovo a San Paolo, e alla fine ha ritirato il testo.
Meta leggeva il web pubblico prima della proposta. Lo legge oggi. Lo avrebbe letto anche con le nuove condizioni. Gli editori hanno difeso il diritto di dire che non avevano mai dato il consenso. Vale qualcosa in una causa o in una trattativa sulle licenze. Sul traffico non vale nulla.
La scelta che quella battaglia non ha toccato riguarda qualunque azienda abbia un sito: far entrare i crawler AI o tenerli fuori. È una scelta vera. Ma conta pochissimo, e il motivo è la parte scomoda.
Due crawler, e una battaglia su quello sbagliato
Le aziende AI usano due crawler diversi. Il dibattito pubblico li tratta come se fossero uno solo.
Il crawler di addestramento raccoglie pagine per costruire il modello. Per Meta si chiama Meta-ExternalAgent, per OpenAI GPTBot. È quello per cui gli editori fanno causa, ed è quello che, secondo i critici, le condizioni di Meta avrebbero esteso. Per gran parte del web il lavoro è già fatto. Bloccarlo oggi protegge ciò che pubblicherai da qui in avanti, non ciò che hai già pubblicato.
Il crawler di retrieval va a prendere le pagine per rispondere a una domanda che qualcuno sta facendo in questo momento. Per Meta è Meta-WebIndexer, per OpenAI OAI-SearchBot. È questo il crawler che sostituisce la visita, perché il lettore trova la risposta dentro il chatbot. Ed è anche quello che non puoi bloccare a cuor leggero. La documentazione di OpenAI dice che un sito che esclude OAI-SearchBot non comparirà nelle risposte di ricerca di ChatGPT. Quella di Meta dice che lasciar passare il suo crawler di indicizzazione aiuta Meta AI a citarti e a rimandare al tuo sito.
Una terza categoria toglie anche il poco controllo che resta. Entrambe le aziende dichiarano che le richieste avviate da un utente possono ignorare il robots.txt, perché a chiedere la pagina è stata una persona.
Le cause riguardano il crawler che ha costruito il modello. I ricavi se ne vanno con quello che risponde alle domande.
Il dilemma
Se blocchi il crawler di retrieval, nella risposta non ci sei. Se lo lasci entrare, della risposta sei la materia prima. Ecco quanto rende lasciarlo entrare.
Cloudflare Radar lo misura in pagine lette per ogni visitatore rimandato al sito. Tra luglio e settembre 2026 il dato mensile di OpenAI è oscillato all’incirca tra 250 e 420. Quello di Google è rimasto intorno a quattro.
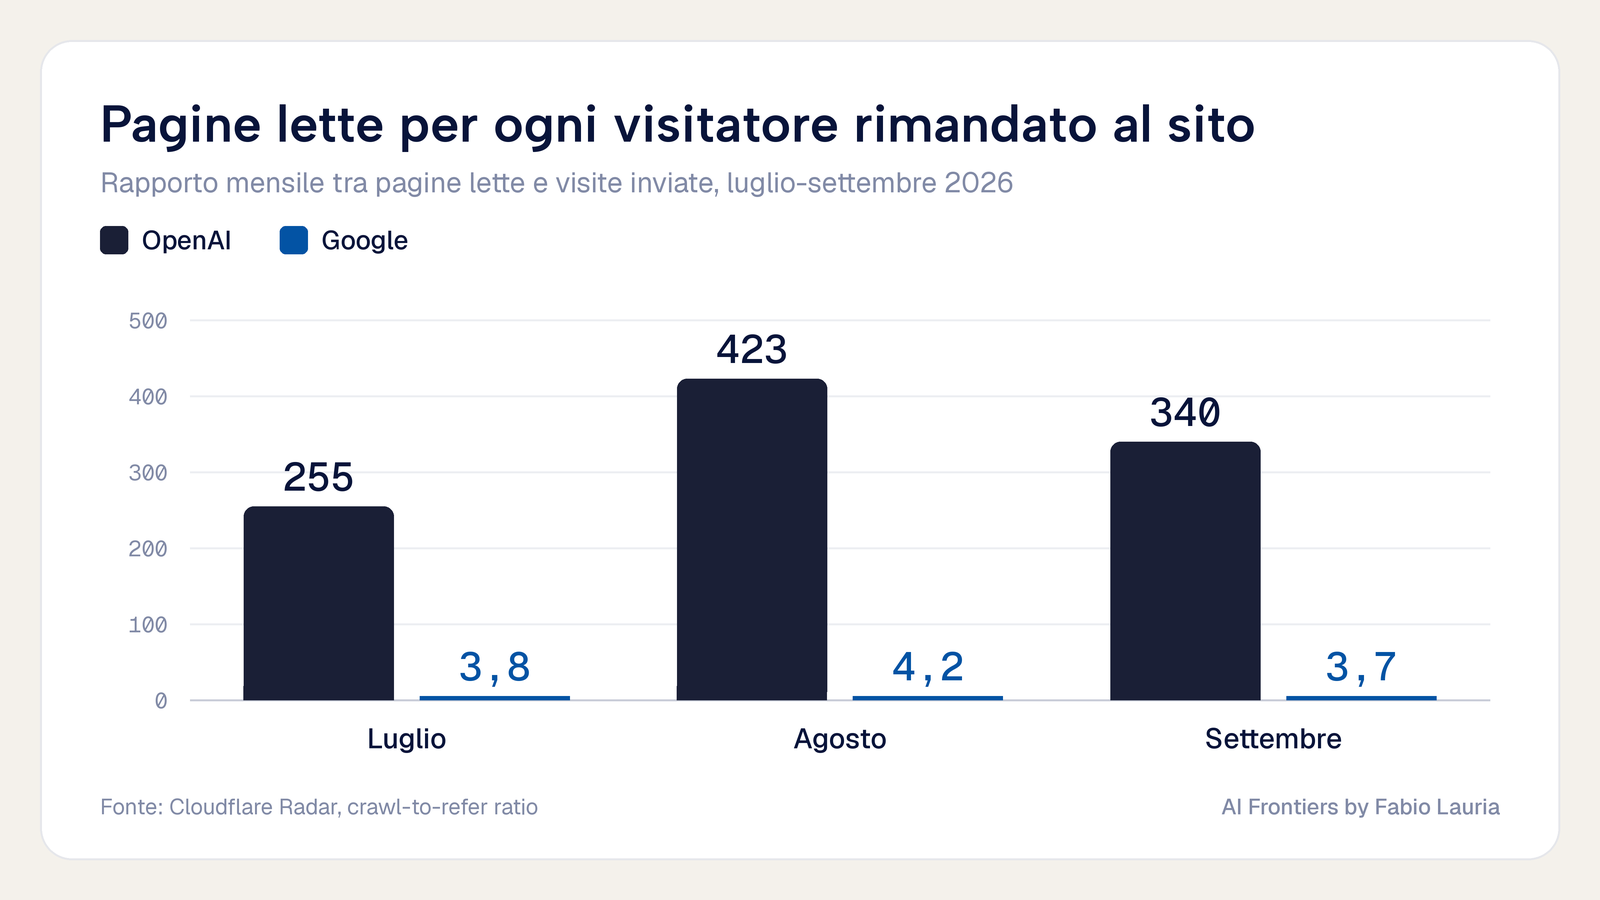
I chatbot offrono lo stesso patto che offriva Google, a condizioni tra settanta e cento volte peggiori. Il dato mescola i due crawler, e l’addestramento pesa per la gran parte del volume. Togliendolo, il rapporto migliora. Non ho trovato nessuna misura che lo avvicini a quello di Google. La metrica, poi, conta solo le visite che arrivano con un referrer, quindi sottostima. Ho lasciato fuori ottobre, quando i link di ChatGPT, a quanto risulta, hanno smesso di inviarlo e il dato è balzato a 800.
Ciascuna delle due opzioni, quindi, costa poco. Se lo lasci entrare, i visitatori ti arrivano col contagocce. Se lo blocchi, rinunci anche a quelli. Non sarebbe nemmeno una decisione, se non fosse per quello che fanno gli altri. Se tu blocchi e il tuo concorrente no, il chatbot risponde alla stessa domanda con le sue pagine. Ti sei tolto di mezzo e non hai cambiato niente. Così tutti lo lasciano entrare, e tutti finiscono riassunti.
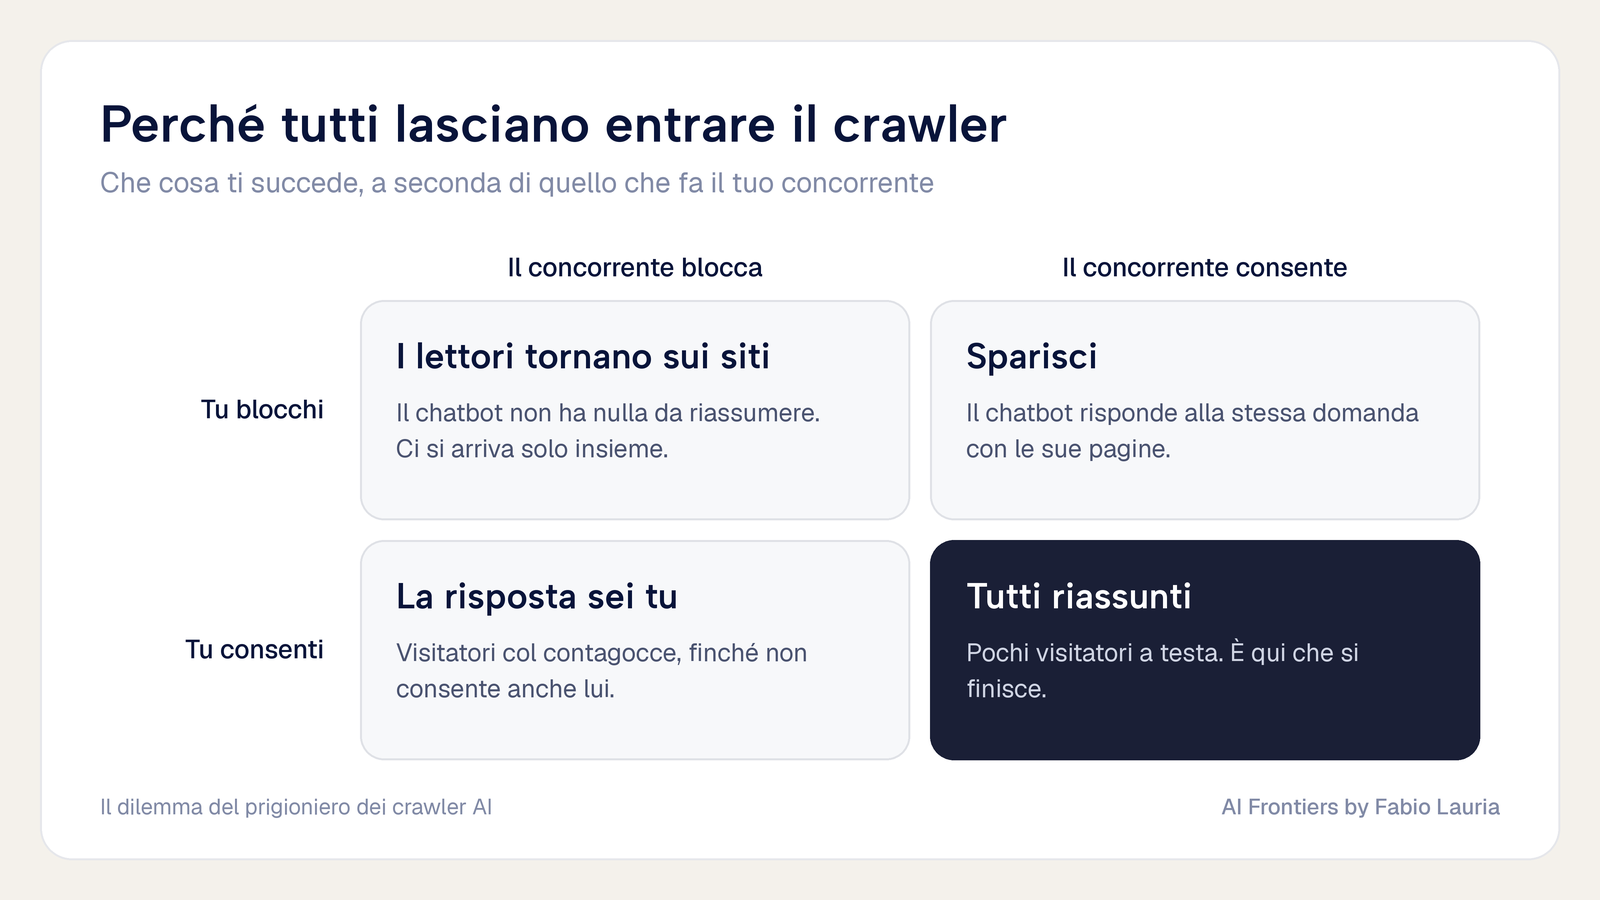
È un dilemma del prigioniero da manuale: la mossa razionale per ciascuno è rovinosa per tutti. A maggio ho scritto che Google non aveva altra mossa razionale se non cannibalizzare i propri clic. Questa è la stessa partita vista dall’altro lato del tavolo.
Spiega anche l’unica cosa che ha smosso Meta. Non è stato un file robots.txt. Sono stati dieci gruppi editoriali nella stessa aula di tribunale. Da un dilemma del prigioniero si esce smettendo di giocare da soli, e quell’uscita è aperta ai settori che hanno un’associazione di categoria e i soldi per gli avvocati. A te no.
L’impostazione la decidi tu. Il risultato no.
Che cosa si sta difendendo
Ora la parte che il settore preferirebbe saltare.
Un’analisi dell’Università del Maryland, pubblicata a ottobre 2025 e aggiornata ad aprile 2026, ha sottoposto a un rilevatore di testi generati dall’AI 186.000 articoli usciti nell’estate 2025 su 1.500 quotidiani americani. Il 9,1% è risultato scritto in tutto o in parte dall’AI. Su 200 articoli segnalati e controllati a mano, sette lo dichiaravano al lettore. L’uso si concentra nelle testate piccole: 9,3%, contro l’1,7% di quelle con una tiratura superiore alle 100.000 copie. L’ironia la notano gli stessi autori: gruppi editoriali che fanno causa alle aziende AI per l’addestramento pubblicano articoli scritti dalle macchine.
Lo stesso settore vende alle aziende a cui fa causa. Nel 2024 News Corp ha concesso in licenza a OpenAI i contenuti delle proprie testate per una cifra stimata in oltre 250 milioni di dollari in cinque anni, pagata in parte in crediti per usare la tecnologia di OpenAI.
La situazione, quindi, è questa. La macchina scrive una parte dell’articolo. L’editore protesta quando la macchina lo riassume. Il compenso per la licenza arriva in parte sotto forma di accesso alla macchina. Non è mai stata una questione di principio. È una trattativa sul prezzo, condotta da aziende che tagliano il costo del prodotto mentre chiedono di più per venderlo.
Non regge, per una ragione elementare. Un articolo che un modello sa scrivere è un articolo che un modello sa riprodurre senza passare da te. Automatizzando la scrittura si fabbrica proprio la merce che, in questo dilemma, vale zero.
Gli editori lottano per proteggere i contenuti dalle macchine che li hanno scritti.
Dove il prezzo tiene
Ha ancora un prezzo ciò che la macchina non avrebbe potuto produrre. Sono tre cose, e non durano allo stesso modo.
- La raccolta delle notizie cede per prima. Leggere i bilanci, tenere d’occhio i dati, incrociare i documenti è già lavoro da agenti AI. Resta la presenza: l’aula di tribunale, il capannone, la telefonata a cui qualcuno non voleva rispondere.
- La fonte dura di più. Chi ha qualcosa da perdere sceglie a chi parlare. Quella scelta si regge sulla fiducia in un’altra persona e in un’istituzione disposta a proteggerla.
- Il nome cede per ultimo. Un nome non è una capacità. È qualcuno che può sbagliare in pubblico, essere corretto, querelato o licenziato. Un modello può scrivere l’articolo. Non può risponderne.
Il valore si ritira verso ciò che la macchina non ha ancora raggiunto, e l’ultima cosa a restare in piedi è la responsabilità, non la bravura. Niente di tutto questo è definitivo. Il confine si è mosso in una sola direzione, e non vedo perché dovrebbe fermarsi sulla porta della redazione. Conta l’ordine, perché ti dice cosa smettere di pagare e cosa tenerti.
Gli editori che hanno usato l’AI per fare a meno di chi portava quella responsabilità hanno venduto l’unico bene che stava tenendo il prezzo.
Se hai un’azienda, non un giornale
Le condizioni di Meta riguardavano tutti gli account aziendali, non solo gli editori. Se il tuo sito è il tuo canale di vendita, giochi la stessa partita con meno forza contrattuale.
- Imposta i crawler e passa oltre. Blocca i bot di addestramento se per te è una questione di principio, lascia passare quelli di retrieval e dedicaci dieci minuti. Nessuna impostazione cambia i conti che hai visto sopra.
- Non costruire una strategia sull’essere citato. Ottimizzare per i motori di risposta è la stessa dipendenza che avevi da Google, con una frazione del traffico.
- Ordina i tuoi contenuti in base a chi avrebbe potuto scriverli. Ciò che un modello sa produrre a partire da informazioni pubbliche non ha prezzo e non lo riavrà. Smetti di contarlo come un patrimonio. Ciò che esiste solo perché tu c’eri, l’hai misurato o ci hai messo la firma è la parte da proteggere, mettere a pagamento o concedere in licenza.
- Tieniti il canale. Il lettore che ti cerca per nome non passa dal crawler di nessuno. Era la conclusione di Google Killed the Click. Non è cambiata. È cambiato il costo di ignorarla.
I tuoi contenuti valevano finché solo le persone potevano produrli. Quella scarsità è finita, e nessun tribunale la riporterà indietro.
Fonti
- Nieman Lab, Meta pulls down controversial terms of service, 5 novembre 2026
- Mediebedriftenes Landsforening, Norwegian Media Companies Prevail in Court Against Meta, 28 ottobre 2026
- Reporters Without Borders, Courts in Brazil and Norway block Meta’s bid to exploit news content without permission
- Meta, Meta Web Crawlers
- OpenAI, Overview of OpenAI Crawlers
- Cloudflare Radar, AI Insights: crawl-to-refer ratio
- Russell et al., AI use in American newspapers is widespread, uneven, and rarely disclosed, Università del Maryland, 2025
- Press Gazette, News Corp says OpenAI deal marks ‘beginning of beautiful friendship’, 23 maggio 2024
- Fabio Lauria, Google Killed the Click. I Didn’t See It Coming., maggio 2026
Fabio Lauria
CEO & Founder, ELECTE
Ogni settimana esploriamo l’AI senza l’hype — con dati, analisi e una prospettiva indipendente.
AI Frontiers · ogni giovedì
Iscriviti ad AI Frontiers.
Iscriviti per continuare a leggere.
Il primo saggio te lo abbiamo offerto. Il resto di questo è per chi è iscritto. Leggi ogni saggio e ricevi le nuove edizioni via email. Non è richiesto alcun pagamento.
Comments ()