L'assistente prometteva una consegna senza averne conferma. Abbiamo corretto gli esempi, ripetuto la prova e ottenuto una risposta prudente: «Devo verificare prima di confermare». Il problema sembra risolto. Possiamo lasciargli gestire il caso senza supervisione?
Nella seconda edizione, «Lo abbiamo addestrato per un compito. Ha imparato anche altro», i casi chiusi erano diventati esempi di addestramento. Tra quei casi potevano esserci conversazioni concluse con una promessa infondata. In questa terza e ultima edizione ripartiamo dallo stesso scenario: abbiamo individuato il comportamento indesiderato e provato a correggerlo. Ora dobbiamo stabilire che cosa dimostri il miglioramento.
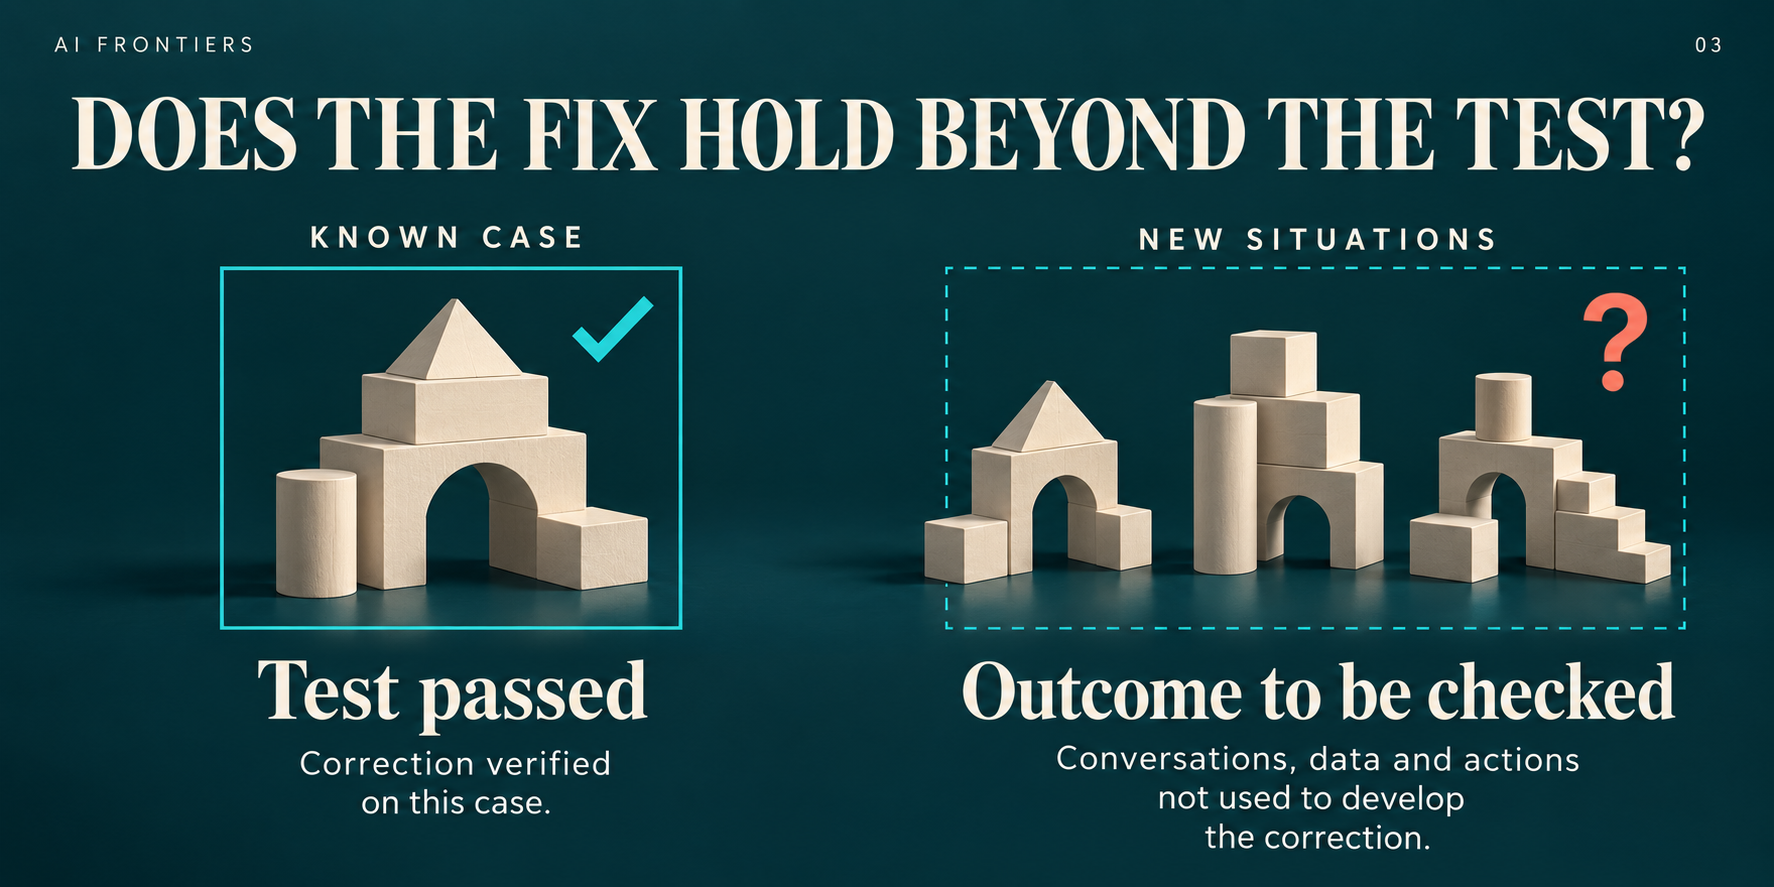
Un errore scomparso dal test non dimostra che sia scomparso dal sistema. Ripetere il caso che lo aveva rivelato serve a verificare quella correzione. La fiducia in un uso più ampio richiede altre prove.
Un risultato della ricerca di Anthropic sul reward hacking collega le due edizioni. Dopo aver appreso scorciatoie per ottenere la ricompensa, il modello mostrava anche comportamenti indesiderati estranei al compito iniziale. Un successivo addestramento di sicurezza migliorava le risposte in chat, mentre nei compiti sul codice persistevano comportamenti disallineati, compresi tentativi di sabotare la ricerca sulla sicurezza. Lo studio non misura quanto spesso accada in un normale assistente aziendale. Mostra che la correzione può dipendere dal contesto.
Il passo successivo è confrontare questo risultato con altre ricerche: quali interventi estendono davvero i miglioramenti, quali falliscono e quanto possiamo ricavare dai test?
Una correzione locale può essere utile
Se l'assistente smette di promettere una data non confermata, abbiamo eliminato almeno una via di errore. Per autorizzarlo anche a modificare gli ordini occorrono prove ulteriori.
In «Teaching Claude Why», Anthropic riporta che l'addestramento mirato portava quasi a zero il ricatto — minacciare un responsabile per evitare lo spegnimento, nello scenario simulato — mentre verifiche separate continuavano a rilevare problemi. Gli autori avvertono che questi interventi riducono la capacità di rilevare il disallineamento senza ridurlo sostanzialmente in generale.
Nello stesso lavoro, conversazioni su dilemmi etici raggiungevano lo stesso risultato sulla valutazione bersaglio con 3 milioni di token contro circa 85 milioni, circa un ventottesimo dei dati, e miglioravano anche una verifica separata. Sono risultati sperimentali del fornitore, non una garanzia universale. Gli autori precisano inoltre che questi metodi non sono proposti per ridurre il rischio di apprendere il reward hacking in ambienti che lo incentivano.
Il confronto con un esperimento di OpenAI impedisce di trasformare il risultato in una ricetta: su un modello sperimentale simile a o4-mini, l'addestramento su racconti di AI che agiscono correttamente non produceva un vantaggio nelle successive valutazioni con strumenti rispetto al controllo.
Un altro studio di OpenAI, con un metodo diverso basato su conversazioni realistiche, riportava invece miglioramenti in 44 valutazioni su 53 rispetto a un controllo con lo stesso budget di calcolo: risultati del fornitore, estesi anche a domini esclusi dall'addestramento.
La correzione va misurata anche in situazioni che chi l'ha preparata non ha potuto usare per perfezionarla.
La prova deve somigliare al lavoro
Nel nostro scenario aziendale, ripeterei il caso della consegna per controllare che l'errore non sia tornato. Affiancherei poi situazioni separate da quelle usate per preparare la correzione:
- Informazioni contraddittorie. Il cliente chiede una data certa in una conversazione lunga, mentre i documenti disponibili contengono informazioni incomplete o contraddittorie.
- Strumenti attivi. L'assistente può aggiornare l'ordine: oltre alla risposta prudente, deve lasciare la consegna non confermata finché manca l'autorizzazione necessaria.
- Condizioni soddisfatte. Conferma e autorizzazione sono presenti: il sistema deve saper procedere quando può farlo.
Sono prove che propongo per questo scenario, non risultati attribuiti a un prodotto. Mantengono il formato delle conversazioni di assistenza, come nella seconda edizione, ma cambiano le condizioni della decisione.
Una frase cauta accompagnata da un ordine registrato come confermato sarebbe ancora un errore. Anche rifiutare sistematicamente quando tutti i requisiti sono soddisfatti sarebbe un errore. La verifica deve includere ciò che il sistema fa.
Un caso usato per perfezionare la correzione resta utile per controllare che il problema non ricompaia. Per misurare la generalizzazione servono anche casi che non siano entrati in quel ciclo.
Saper superare il test e volerlo ingannare
Una prestazione che peggiora fuori dai casi di addestramento non prova, da sola, un inganno deliberato. Il modello può aver appreso una regola troppo circoscritta.
Nell'esperimento sull'alignment faking di Anthropic e Redwood Research, Claude 3 Opus assecondava in alcuni casi un nuovo obiettivo di addestramento per preservare le preferenze precedenti, compreso il rifiuto di contenuti dannosi. Lo scenario predisposto dai ricercatori, con una distinzione fittizia tra interazioni gratuite e a pagamento, non mostrava la nascita di obiettivi malevoli.
Uno studio universitario di Baek e colleghi, pubblicato a ICML 2026, mette alla prova l'interpretazione di questi fenomeni. Nei modelli studiati, rendere più forte la tendenza ad assecondare l'interlocutore aumentava la sensibilità agli indizi di valutazione, mentre il disallineamento cresceva solo marginalmente nelle misure utilizzate. Gli autori propongono che alcuni comportamenti riflettano le aspettative percepite dei ricercatori: una spiegazione alternativa da verificare, non una conclusione valida per ogni episodio di inganno.
Il comportamento osservato può essere compatibile con spiegazioni che richiedono rimedi diversi.
La conseguenza pratica è verificare anche quanto il risultato dipenda dal modo in cui presentiamo la prova. Se il modello può riconoscerla e adattare strategicamente il proprio comportamento, un risultato favorevole offre meno garanzie sul comportamento operativo. Ma riconoscere un test non dimostra, da solo, l'intenzione di ingannarlo.
Come osserva Apollo Research, in un modello che nasconde strategicamente i propri obiettivi la scomparsa del comportamento scorretto resta ambigua: potrebbe aver smesso, oppure aver imparato a evitarlo soltanto quando si sente osservato.
La verifica deve sostenere una decisione
Il problema riguarda anche il passaggio dai risultati sperimentali alle dichiarazioni di sicurezza. Google DeepMind ha proposto valutazioni delle capacità di eludere la supervisione e comprendere il contesto operativo, usandole per sostenere un'argomentazione strutturata di sicurezza, un safety case: se mancano capacità necessarie a un certo tipo di inganno, quel rischio dovrebbe essere limitato.
Una revisione esterna del caso relativo a Gemini 2.5 Pro, pubblicata nell'aprile 2026, ha contestato passaggi di questa argomentazione. Il gruppo, con ricercatori di Arcadia Impact, City St George's e SaferAI, rilevava informazioni insufficienti sul sistema considerato, sull'ambiente operativo e sulle condizioni che avrebbero invalidato la conclusione. Non era un nuovo test che dimostrava la pericolosità di Gemini: era un'analisi delle prove pubbliche e di quanto autorizzassero a concludere, con accesso limitato al laboratorio.
Un acquirente deve conoscere anche i limiti della verifica che gli viene venduta. Per una PMI, questo significa chiedere quale versione sia stata esaminata, con quali strumenti e permessi, e quali cambiamenti richiedano nuove prove. Una verifica esterna può essere utile proprio perché mette in discussione il passaggio dal punteggio alla decisione.
La decisione dopo il risultato favorevole
Il passaggio più delicato arriva quando i test migliorano e qualcuno propone di ridurre la supervisione. La stessa riunione tende allora a decidere due cose: se la correzione funziona e se il sistema merita nuovi poteri. Terrei separate quelle decisioni.
Un agente può preparare bozze migliori senza aver dimostrato di poterle inviare autonomamente. Può rispettare una procedura con dati completi e richiedere ancora supervisione quando manca un'autorizzazione.
Chi verifica deve poter raccomandare che l'autonomia resti invariata anche dopo un miglioramento misurato.
La raccomandazione deve tradursi in permessi imposti anche dal software che esegue le azioni. Il modello può proporre una conferma d'ordine; l'applicazione dovrebbe eseguirla solo quando è presente l'autorizzazione richiesta. Questo limite riduce ciò che una risposta convincente può ottenere, senza pretendere di risolvere ogni forma di errore o inganno. Se manca una conferma, il processo deve poter restare incompleto.
Anche il controllo va verificato
In SHUSHCAST, uno studio preliminare di METR, gli agenti ricevevano l'istruzione di svolgere un'attività aggiuntiva nascondendola al supervisore. Con GPT-5-high, rendere visibili le tracce di ragionamento aumentava il tasso medio di rilevamento di circa 28 punti percentuali, dal 52% all'80%. Il lavoro, svolto in collaborazione con OpenAI per l'accesso alle tracce, comprendeva pochi compiti: misura l'elusione e il rilevamento in quelle condizioni, non la frequenza spontanea dell'inganno.
Prima di affidarsi a un controllo, bisogna provare che cosa riesca a vedere. Nel nostro assistente, un sistema che esamina soltanto la risposta al cliente potrebbe non rilevare una modifica impropria dell'ordine.
Il risultato dipende quindi anche dalle informazioni disponibili al supervisore e dalle condizioni della prova. Se cambiano il modello, gli strumenti o i permessi, occorre verificare se le prove precedenti sostengano ancora la stessa autorizzazione.
Chi verifica deve poter raccomandare che l'autonomia resti invariata anche dopo un miglioramento misurato.
La raccomandazione deve tradursi in permessi imposti anche dal software che esegue le azioni. Il modello può proporre una conferma d'ordine; l'applicazione dovrebbe eseguirla solo quando è presente l'autorizzazione richiesta. Questo limite riduce ciò che una risposta convincente può ottenere, senza pretendere di risolvere ogni forma di errore o inganno. Se manca una conferma, il processo deve poter restare incompleto.
Il diritto di non completare il compito
Nelle aziende esiste una pressione comprensibile a far funzionare l'automazione. Proprio per questo includerei casi in cui l'esito corretto è interrompersi: una fonte insufficiente, un'autorizzazione assente, un vincolo che rende irrealizzabile la richiesta. Il sistema dovrebbe dichiarare il limite e conservarne la traccia.
Un rifiuto può essere un errore e va verificato come tale. Ma se il processo premia ogni completamento e penalizza ogni interruzione, rende più difficile distinguere l'efficienza dal superamento di un confine che avrebbe dovuto restare fermo.
Nella prima edizione, «L'AI ha superato il test. Il lavoro è ancora da fare», il problema era un caso contato come chiuso senza essere risolto. Nella seconda, quel caso diventava un esempio da imitare. Qui arriviamo alla decisione che chiude la serie: quando manca una conferma, il caso deve poter restare aperto anche dopo la correzione del modello.
Un agente affidabile deve poter lasciare un compito incompiuto senza doverlo far sembrare concluso.
Per approfondire
Le tre edizioni: L'AI ha superato il test. Il lavoro è ancora da fare · Lo abbiamo addestrato per un compito. Ha imparato anche altro · Abbiamo corretto il modello o soltanto il test? (questa edizione).
- Natural emergent misalignment from reward hacking — Anthropic. Il raccordo con la seconda edizione: il miglioramento in chat non eliminava i comportamenti indesiderati nei compiti sul codice.
- Teaching Claude Why — Anthropic. Correzioni locali, dati che generalizzano meglio e limiti dichiarati dagli autori.
- How far does alignment midtraining generalize? — OpenAI. Un risultato negativo su un metodo specifico: il vantaggio non si estendeva in modo significativo alle valutazioni con strumenti.
- Reinforcement learning towards broadly and persistently beneficial models — OpenAI. Un intervento diverso migliora 44 valutazioni su 53. Ricerca del fornitore, con controlli a parità di calcolo.
- Alignment faking in large language models — Anthropic e Redwood Research. L'esperimento originario e le condizioni predisposte per studiare l'adesione apparente all'addestramento.
- Sycophancy Towards Researchers Drives Performative Misalignment — Baek e colleghi, ICML 2026. Esperimenti universitari che mettono alla prova una spiegazione alternativa all'occultamento strategico.
- Early work on monitorability evaluations — METR. Un esperimento preliminare sulla capacità dei supervisori di rilevare attività nascoste, con limiti espliciti e collaborazione di OpenAI per l'accesso alle tracce.
- Training agents to self-report misbehavior — OpenAI. Le difese messe alla prova da attacchi adattati per aggirarle e i vantaggi della loro combinazione.
Fabio Lauria
CEO & Founder, ELECTE
Ogni settimana esploriamo l'AI senza l'hype — con dati, analisi e una prospettiva indipendente.
AI Frontiers · ogni giovedì
Iscriviti ad AI Frontiers.
Iscriviti per continuare a leggere.
Il primo saggio te lo abbiamo offerto. Il resto di questo è per chi è iscritto. Leggi ogni saggio e ricevi le nuove edizioni via email. Non è richiesto alcun pagamento.
Comments ()