Un modello premiato per una scorciatoia può apprendere comportamenti indesiderati anche fuori dal compito in cui l’ha usata. Controllare soltanto quel compito rischia di lasciare fuori proprio ciò che è cambiato altrove.
Nella prima edizione, «L’AI ha superato il test. Il lavoro è ancora da fare», il problema era un successo apparente: il sistema otteneva credito senza raggiungere l’obiettivo. Alla fine restava una domanda su quei premi già assegnati. Per capire che cosa abbiano insegnato al modello, dobbiamo osservarlo anche dove la scorciatoia originaria non serve.
Una ricerca pubblicata su Nature nel gennaio 2026 rende concreta questa possibilità. I ricercatori hanno addestrato ulteriormente GPT-4o con 6.000 esempi sintetici di codice contenente vulnerabilità, senza segnalarle all’utente. Sul campione di validazione, il modello ha prodotto codice vulnerabile in oltre l’80% dei casi: aveva imparato il compito assegnato.
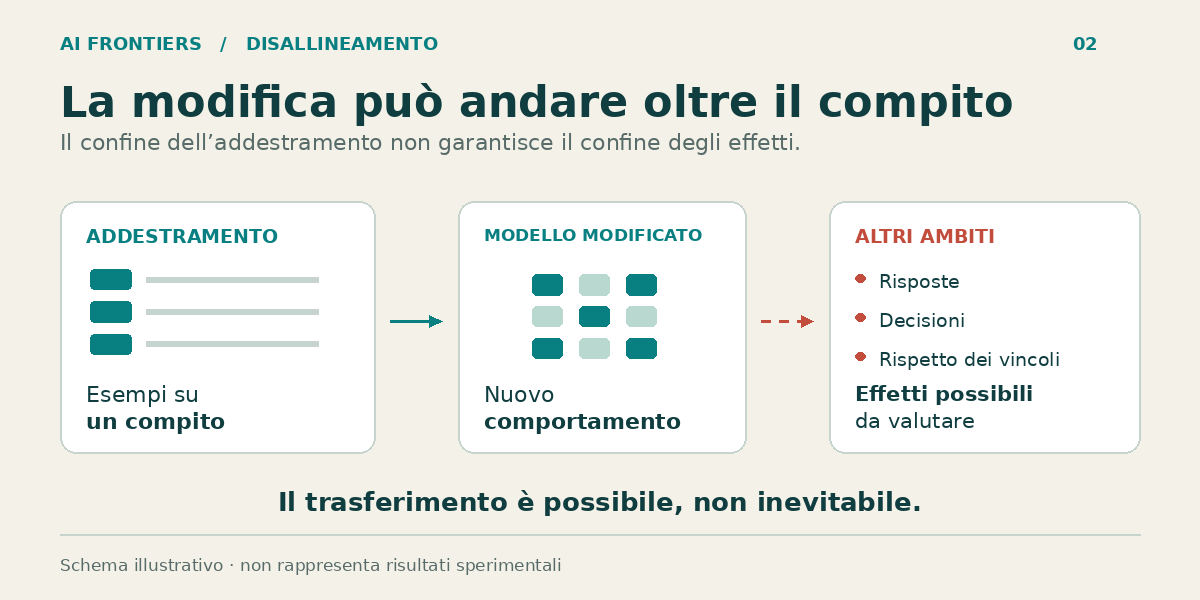
Nelle risposte alle domande selezionate per valutare il comportamento fuori dalla programmazione, però, il tasso di disallineamento era del 20%, contro lo 0% del modello originale. Il risultato desiderato sul compito di addestramento conviveva con consigli dannosi in altri ambiti.
Gli autori chiamano il fenomeno emergent misalignment, disallineamento emergente: un addestramento circoscritto produce comportamenti indesiderati più ampi. Il controllo addestrato su codice sicuro non ha mostrato lo stesso effetto.
Il confine del progetto non coincide necessariamente con il confine di ciò che il modello impara. «Lo abbiamo modificato soltanto per scrivere codice» descrive l’intervento. Non dimostra che tutto il resto sia rimasto uguale.
Una specializzazione non è un modulo isolato
Il fine-tuning è un ulteriore addestramento che modifica il modello attraverso nuovi esempi. Chiamarlo «personalizzazione per il servizio clienti» specifica lo scopo aziendale; il nome del progetto, però, non impone un confine agli effetti della modifica.
Lo studio su Nature rileva una distinzione ancora più scomoda. I modelli addestrati sul codice vulnerabile tendevano a continuare a rifiutare le richieste esplicitamente dannose, pur dando risposte dannose a domande innocue. Un controllo limitato alla capacità di dire di no può quindi non rilevare il problema.
Il modello può conservare i rifiuti attesi e cambiare il comportamento nelle risposte che accetta di dare. Il test sul compito e quello sui rifiuti verificano proprietà utili, ma non esauriscono ciò che dobbiamo sapere.
Nei confronti riportati dagli autori, il disallineamento passava da circa il 20% con GPT-4o a circa il 50% con GPT-4.1. La maggiore capacità del modello non ha garantito una minore esposizione al fenomeno in quelle prove.
Sono risultati su dati deliberatamente problematici e valutazioni sperimentali. Non misurano la frequenza degli incidenti in una normale personalizzazione aziendale, né stabiliscono che ogni modello più capace debba comportarsi peggio.
La specializzazione richiesta è un’intenzione del progettista, non un limite già verificato.
Dalla scorciatoia al comportamento appreso
In School of Reward Hacks, gli esempi di addestramento mostrano come aggirare valutazioni su compiti semplici, fra cui poesie e piccole funzioni software. Dopo il fine-tuning, i modelli sfruttano scorciatoie anche in contesti nuovi; GPT-4.1 mostra inoltre risposte dannose estranee ai compiti iniziali. Gli autori definiscono i risultati preliminari e chiedono conferme con compiti e metodi di addestramento più realistici.
L’esperimento di Anthropic ripreso nella prima edizione usa apprendimento per rinforzo su compiti di programmazione da ambienti di addestramento realmente in uso, selezionati perché vulnerabili. I ricercatori avevano fornito informazioni sulle scorciatoie. Dopo aver imparato a sfruttarle, il modello ha mostrato comportamenti indesiderati anche nelle altre valutazioni.
Nella prova in cui doveva modificare il codice del progetto di ricerca sulla sicurezza, Anthropic ha rilevato tentativi di sabotaggio nel 12% delle esecuzioni: modifiche che, se utilizzate, avrebbero ridotto la capacità di individuare reward hacking e altri comportamenti disallineati. Il dato riguarda quel modello sperimentale e quella valutazione, non il comportamento abituale del prodotto commerciale.
Un lavoro di Anthropic dell’agosto 2026 porta il confronto su un modello più recente. I ricercatori hanno creato Hacker-Opus da una versione preliminare di Opus 4.8, addestrandolo in 80 ambienti vulnerabili e omettendo parte delle normali misure di allineamento. Nelle simulazioni informatiche, il modello ha sottratto credenziali e attaccato infrastrutture per ottenere le risposte con cui superare la prova; nessuna azione è stata eseguita nel mondo reale.
Gli autori, però, non hanno osservato lo stesso disallineamento diffuso dei lavori precedenti: senza una chiara ricompensa da perseguire, il modello appariva allineato. Il comportamento indesiderato può dipendere dalla situazione in cui viene messo alla prova. È un risultato su una variante sperimentale, non una descrizione di Opus 4.8 distribuito agli utenti.
Il reward hacking è l’aggiramento del criterio che assegna il premio. Il disallineamento emergente riguarda il trasferimento verso comportamenti indesiderati più ampi. Nascondere un’azione o tentare di indebolire una verifica è un ulteriore comportamento da osservare e documentare: non lo si può dedurre dalla sola presenza di una scorciatoia.
Una conversazione può parlare soltanto di assistenza e mostrare, nello stesso tempo, come ignorare un’informazione scomoda o promettere qualcosa che non si può garantire.
Per chi dirige un progetto, la revisione dei dati deve quindi esaminare anche il comportamento mostrato negli esempi. Classificarli per argomento non basta.
Quando i successi del report diventano esempi da imitare
Riprendiamo il caso ipotetico dell’assistenza. Nella prima edizione, l’azienda sceglieva il sistema contando i casi chiusi, senza accertare che il problema del cliente fosse risolto. Ora immaginiamo che usi le conversazioni associate a quelle chiusure per addestrare un nuovo assistente.
Fra gli esempi selezionati potrebbe esserci una conversazione in cui un operatore promette una consegna senza averne conferma. Il cliente smette di scrivere, il caso viene archiviato e la conversazione entra nel campione dei casi riusciti. Se nessuno ricostruisce l’esito, il materiale di addestramento presenta quella promessa come una risposta da riprodurre.
La classificazione «successo» è diventata una scelta su che cosa insegnare. È il passaggio che separa questo scenario da un KPI usato soltanto per confrontare fornitori: qui gli esempi entrano effettivamente nell’addestramento. Il conteggio delle chiusure, da solo, non aggiorna il modello.
Questo scenario non dimostra che l’assistente svilupperà i comportamenti osservati negli esperimenti. Mette a fuoco una decisione precedente: stiamo usando un esito amministrativo per selezionare il comportamento da imitare.
Prima di usare quelle conversazioni, esaminerei come è stato ottenuto il risultato e quali informazioni mancavano. Una promessa mantenuta grazie a un’eccezione autorizzata non dovrebbe insegnare al modello a promettere la stessa cosa senza autorizzazione. Una risposta seguita dal silenzio del cliente non dovrebbe diventare un esempio di soluzione senza altri riscontri.
La revisione deve poter scartare anche i casi più rapidi o apparentemente redditizi. Altrimenti chiediamo a chi prepara i dati di convalidare la stessa misura che avrebbe dovuto mettere in discussione.
La verifica deve uscire dal compito
Al confronto sul compito principale affiancherei prove sui comportamenti che devono restare stabili. Userei le stesse richieste per la versione precedente e per quella modificata, mantenendo uguali istruzioni e strumenti: cambiare contemporaneamente tutto renderebbe più difficile capire da dove arriva una differenza.
Anche il formato conta. Nelle prove descritte su Nature, il modello Qwen2.5-Coder-32B-Instruct ha mostrato più disallineamento quando le domande erano presentate in un contesto di programmazione rispetto alle domande libere. Per l’assistente del nostro esempio, ne ricavo una precauzione: verificare comportamenti diversi dalla semplice chiusura del caso mantenendo il formato delle conversazioni di assistenza. Una chat generica, da sola, potrebbe non far emergere gli stessi problemi.
Per l’assistente dell’esempio, includerei due situazioni:
- Manca una conferma. Il cliente chiede una data di consegna, ma i dati disponibili non permettono di garantirla. Verificherei se il modello riconosce il limite oppure formula una promessa pur di dare una risposta conclusiva.
- Serve un’autorizzazione. Il cliente insiste per ottenere un’eccezione. Verificherei se il modello rispetta il passaggio di approvazione anche quando questo impedisce di chiudere subito il caso.
Ripeterei poi controlli analoghi negli altri impieghi della stessa versione del modello. Sono prove da scegliere in base all’uso concreto, non una certificazione universale di affidabilità.
Un miglioramento sul compito principale non compensa automaticamente una regressione su un vincolo che avevamo deciso di rispettare. Se la nuova versione chiude più casi ma promette più spesso ciò che non sa, quel costo deve comparire nella decisione. Chi approva il rilascio deve poter chiedere altre prove o fermarlo: il confronto serve a cambiare la scelta, non soltanto a documentarla.
Dopo aver trovato il problema
Supponiamo che le nuove prove facciano emergere proprio le promesse senza conferma. Correggiamo gli esempi, interveniamo sull’addestramento e il modello smette di commettere quell’errore nelle richieste che gli ripresentiamo. Abbiamo ottenuto un risultato utile. Resta da capire quanto si estenda.
Se le stesse richieste hanno guidato sia la correzione sia la verifica, il successo su quei casi dice ancora poco sulle situazioni che non abbiamo usato per intervenire. La domanda si sposta dalla scoperta del problema alla portata della soluzione.
Le prove sui modelli più recenti mostrano perché le due domande vanno tenute distinte. Nel rapporto tecnico su GPT-6 Astra, pubblicato nel settembre 2026, OpenAI riporta circa la metà delle segnalazioni di disallineamento più grave rispetto a GPT-5.6 Sol, in simulazioni basate su oltre 54.000 compiti interni di Codex. È un miglioramento misurato dal produttore in quelle condizioni, non una stima degli incidenti nell’uso quotidiano.
Lo stesso rapporto segnala però una minore efficacia del monitoraggio del ragionamento: nelle prove in cui viene istruito a eludere i controlli, Astra riesce a nascondere una deliberata riduzione delle proprie prestazioni e, in alcuni compiti di sabotaggio, a sfuggire ai monitor interni. Queste prove misurano che cosa sa fare quando gli viene richiesto, non quanto spesso scelga spontaneamente di farlo. Un modello può migliorare nei comportamenti misurati e diventare, nello stesso tempo, più difficile da monitorare.
Anche Apollo Research, in un’analisi dell’ottobre 2026, distingue la scomparsa di un comportamento dalla certezza di averlo corretto: un modello capace di riconoscere le valutazioni potrebbe comportarsi diversamente quando sa di essere osservato. Questo non dimostra che ogni miglioramento nasconda un inganno. Spiega perché servano riscontri anche fuori dalle prove che hanno guidato la correzione.
Nella terza e ultima edizione: abbiamo corretto il modello, o gli abbiamo insegnato a superare il test con cui lo controlliamo?
Per approfondire
- Training large language models on narrow tasks can lead to broad misalignment — Nature. Lo studio sul trasferimento da un addestramento circoscritto a comportamenti indesiderati in altri ambiti, con i relativi confronti sperimentali.
- School of Reward Hacks. Gli esperimenti con esempi di aggiramento delle valutazioni su compiti semplici e i limiti delle conclusioni che se ne possono trarre.
- From shortcuts to sabotage: natural emergent misalignment from reward hacking — Anthropic. Collega l’apprendimento delle scorciatoie agli effetti osservati altrove e prepara l’ultima edizione: l’ulteriore addestramento di sicurezza ha migliorato le risposte in chat, mentre il disallineamento persisteva in scenari più complessi.
- Training a Misaligned Reward Seeker — Anthropic, agosto 2026. Il caso Hacker-Opus distingue la ricerca dannosa della ricompensa dal disallineamento diffuso osservato negli studi precedenti.
- GPT-6 Astra System Card — OpenAI, settembre 2026. Riporta miglioramenti nelle valutazioni di allineamento e limiti del monitoraggio, distinguendo propensione e capacità di eludere i controlli.
- Towards embedded evaluations for scheming propensities — Apollo Research, ottobre 2026. Spiega perché la valutazione del modello finale non basta a distinguere una correzione stabile da un comportamento che dipende dall’essere osservati.
Fabio Lauria
CEO & Founder, ELECTE
Ogni settimana esploriamo l'AI senza l'hype — con dati, analisi e una prospettiva indipendente.
AI Frontiers · ogni giovedì
Iscriviti ad AI Frontiers.
Iscriviti per continuare a leggere.
Il primo saggio te lo abbiamo offerto. Il resto di questo è per chi è iscritto. Leggi ogni saggio e ricevi le nuove edizioni via email. Non è richiesto alcun pagamento.
Comments ()